

 Member
 Victorhck
#openSUSE Tumbleweed revisión de la semana 43 de 2026
Tumbleweed es una distribución de GNU/Linux «Rolling Release» o de actualización contínua. Aquí puedes estar al tanto de las últimas novedades.

openSUSE Tumbleweed es la versión «rolling release» o de actualización continua de la distribución de GNU/Linux openSUSE.
Hagamos un repaso a las novedades que han llegado hasta los repositorios esta semana.
Y recuerda que puedes estar al tanto de las nuevas publicaciones de snapshots en esta web:
El anuncio original lo puedes leer en el blog de Dominique Leuenberger, publicado bajo licencia CC-by-sa, en este este enlace:
Esta semana se ha publicado un total de 5 snapshots (1016, 1017, 1018, 1020, y 1021).
Los titulares más grandes en el panorama tecnológico más amplio giraban en torno a la seguridad, específicamente las vulnerabilidades críticas de ejecución remota de código en PHP denominadas “PHP2Shell” (CVE-2026-109618 y CVE-2026-109619).
Los usuarios de Tumbleweed estaban protegidos rápidamente cuando la instantánea 1021 entregó PHP 8.5.12 que aborda ambos defectos.
Estas son las actualizaciones más importantes de esta semana:
- 7zip 26.04
- containerd 2.3.3
- cups 2.4.20
- curl 8.23.0
- freetype2 2.15.0
- gedit 51.0
- GraphicsMagick 1.3.49
- KDE Plasma 6.8.0
- Linux Kernel 7.2.11
- Mesa 26.2.5
- MozillaFirefox 158.0
- php8 8.5.12
- pipewire 1.6.9
- polkit 128
- Qt 6.12.0
- sqlite3 3.54.1
- systemd 261.4
- tmux 3.8
- vim 9.2.1202
Y para próximas snapshots, ya se están preparando las siguientes actualizaciones:
- GNOME 51.1
- Linux Kernel 7.3.0
- Ollama 0.40.9
- HarfBuzz 15.0.0
- Ruby 4.0.9
- Go 1.27.3
- VirtualBox 7.2.22
- fmt 12.2.0
- Swig 4.5.0
Si quieres estar a la última con software actualizado y probado utiliza openSUSE Tumbleweed la opción rolling release de la distribución de GNU/Linux openSUSE.
Mantente actualizado y ya sabes: Have a lot of fun!!
Enlaces de interés
- ¿Por qué deberías utilizar openSUSE Tumbleweed?
- zypper dup en Tumbleweed hace todo el trabajo al actualizar
- ¿Cual es el mejor comando para actualizar Tumbleweed?
- ¿Qué es el test openQA?
- http://download.opensuse.org/tumbleweed/iso/
- https://es.opensuse.org/Portal:Tumbleweed
——————————–
Gaming en Linux + taller de ayuda e instalación, nuevo evento organizado por GNU/Linux València
Organizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en su nuevo evento: Gaming en Linux, que como es tradicional por la precedida por la Install Party que ayudará a las personas no iniciadas a entrar en el maravilloso mundo libre. Como es habitual se celebrará en las Naves y la fechas será el 30 de octubre a partir de las 17:00 horas. Otra tarde de conocimiento compartido.
Gaming en Linux + taller de ayuda e instalación, nuevo evento organizado por GNU/Linux València
Me complace presentaros un nuevo evento de la Asociación sin Ánimo de Lucro GNU/Linux València que siguen sus actividades este 2026 con una jornada que incidirá sobre uno de los pocos bastiones que quedan en pie en el dominio de los sistemas libres: los videojuegos.
En palabras de los organizadores:
¿Se puede jugar de verdad en GNU/Linux? Hace unos años la pregunta era arriesgada; hoy, la respuesta es un sí rotundo.
Ven el 30 de octubre a Las Naves y descubre de dónde viene el gaming en el pingüino, dónde está ahora y hacia dónde va, todo contado desde el punto de vista de quien juega. Entrada libre. ¡Install party incluída!
Este próximo viernes 30 de octubre regresamos a Las Naves —como cada último viernes de mes— con una charla sobre gaming en GNU/Linux: una mirada al pasado, presente y futuro del gaming desde el punto de vista del usuario.
17:00 – Primer, un Taller d’ajuda GNU/Linux i més 
Vols fer el salt a GNU/Linux? T’has decidit a deixar enrere Windows o Mac però no saps per on començar? Ja uses Linux però alguna configuració se te resisteix?
En la nostra Install Party et donem un colp de mà. No importa el teu nivell d’experiència: des de principiants fins a usuaris avançats, tot el món és benvingut. Porta el teu equip i ens posem mans a l’obra.
A partir de les 17:00 podràs venir a:
Instal·lar GNU/Linux al teu ordinador  (Recorda: fes una còpia de seguretat de les teues dades més valuoses primer!
 )
Aprendre a bloquejar anuncis i rastrejadors al teu mòbil 
Descobrir i instal·lar aplicacions lliures i conèixer els seus avantatges enfront del programari privatiu 
Explorar xarxes socials federades i mitjans de comunicació alternatius 
Resoldre dubtes o problemes tècnics del teu sistema actual 
18:30 – Xarrada: Gaming en Linux 
En aquesta segona part de la vesprada, de 18:30 a 20:00, farem una mirada al passat, present i futur del gaming des del punt de vista de l’usuari: els mites, les fites i les eines que ho canviaren tot. Sense tecnicismes innecessaris i amb temps de sobres per a preguntes i xarradeta.
Veurem coses com:
el passat: els primers passos per a jugar en GNU/Linux — Wine, els jocs natius i els mites que encara arrosseguem 
el present: Proton, la Steam Deck i per què hui jugar en el pingüí està a l’abast de tothom
el futur: tendències, reptes pendents (anti-cheats, us mirem!) i el que està per vindre 
recursos i consells pràctics per a començar —o millorar— hui mateix 
17:00 – Primero, un Taller de ayuda GNU/Linux y más
¿Quieres dar el salto a GNU/Linux? ¿Te has decidido a dejar atrás Windows o Mac pero no sabes por dónde empezar? ¿Ya usas Linux pero alguna configuración se te resiste?
En nuestra Install Party te echamos una mano. No importa tu nivel de experiencia: desde principiantes hasta usuarios avanzados, todo el mundo es bienvenido. Trae tu equipo y nos ponemos manos a la obra.
A partir de las 17:00 podrás venir a:
Instalar GNU/Linux en tu ordenador (Recuerda: ¡haz una copia de seguridad de tus datos más valiosos primero! )
Aprender a bloquear anuncios y rastreadores en tu móvil
Descubrir e instalar aplicaciones libres y conocer sus ventajas frente al software privativo
Explorar redes sociales federadas y medios de comunicación alternativos
Resolver dudas o problemas técnicos de tu sistema actual
18:30 – Charla: Gaming en Linux
En esta segunda parte de la tarde, de 18:30 a 20:00, haremos una mirada al pasado, presente y futuro del gaming desde el punto de vista del usuario: los mitos, los hitos y las herramientas que lo cambiaron todo. Sin tecnicismos innecesarios y con tiempo de sobra para preguntas y charleta.
Veremos cosas como:
el pasado: los primeros pasos para jugar en GNU/Linux — Wine, los juegos nativos y los mitos que todavía arrastramos
el presente: Proton, la Steam Deck y por qué hoy jugar en el pingüino está al alcance de cualquiera
el futuro: tendencias, retos pendientes (¡anti-cheats, os miramos!) y lo que está por llegar
recursos y consejos prácticos para empezar —o mejorar— hoy mismo

¡Recuerda! 

-
 Viernes 30 de octubre de 2026
-
 ¡Entrada libre!
-
 Edificio Las Naves (Calle Joan Verdeguer, 16, 46024, Valencia)
-
 17:00 Taller de instalación / ayuda GNU/Linux
-
 18:30 Charla: Gaming en Linux (hasta las
 Viernes 30 de octubre de 2026
 ¡Entrada libre!
 Edificio Las Naves (Calle Joan Verdeguer, 16, 46024, Valencia)
 17:00 Taller de instalación / ayuda GNU/Linux
 18:30 Charla: Gaming en Linux (hasta las
Más información: GNU/Linux València
¡Únete a GNU/Linux València!
Aprovecho para recordar que desde hace unos meses, los chicos de GNU/Linux Valencia ya tienen su menú propio en el blog, con lo que seguir sus eventos en esta humilde bitácora será más fácil que nunca, y así podréis comprobar su alto nivel de actividades que realizan que destacan por su variedad.
Y que además, GNU/Linux València creció y se ha convertió en asociación. Así que si buscas una forma de colaborar con el Software Libre, esta asociación puede ser tu sitio. ¡Te esperamos!
-
Gaming en Linux + taller de ayuda e instalación, nuevo evento organizado por GNU/Linux València
 Organizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en su nuevo evento: Gaming en Linux, que como es tradicional por la precedida por la Install Party que ayudará a las personas no iniciadas a entrar en el maravilloso mundo libre.
-
«El Activo Eres Tú» de Carles Tamayo, nuevo evento organizado por GNU/Linux València
 Organizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en su nuevo evento: Debate sobre el documental «El Activo Eres Tú» de Carles Tamayo que… Leer más: «El Activo Eres Tú» de Carles Tamayo, nuevo evento organizado por GNU/Linux València
-
¡Aprende a usar GNU/Linux! Taller práctico – nueva charla organizada por GNU/Linux València
 Organizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en la charla ¡Aprende a usar GNU/Linux! Taller práctico – nueva charla organizada por GNU/Linux València… Leer más: ¡Aprende a usar GNU/Linux! Taller práctico – nueva charla organizada por GNU/Linux València
-
¡Aprende a usar GNU/Linux! Taller práctico – nueva charla organizada por GNU/Linux ValènciaOrganizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en la charla ¡Aprende a usar GNU/Linux! Taller práctico – nueva charla organizada por GNU/Linux València… Leer más: ¡Aprende a usar GNU/Linux! Taller práctico – nueva charla organizada por GNU/Linux València
-
¡Hablemos! Bloqueo de anuncios, anti-tracking, anonimización – nueva charla organizada por GNU/Linux València
 Organizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en la charla ¡Hablemos! Bloqueo de anuncios, anti-tracking, anonimización que se celebrará hoy 27 de junio… Leer más: ¡Hablemos! Bloqueo de anuncios, anti-tracking, anonimización – nueva charla organizada por GNU/Linux València
-
¡Libera tu ordenador/móvil con nosotros! ¡Campaña por el fin de Windows 10! – nueva charla organizada por GNU/Linux València
 Organizada por la asociación sin ánimo de lucro GNU/Linux València os invito a participar en la charla «¡Libera tu ordenador/móvil con nosotros! ¡Campaña por el fin de Windows 10! que… Leer más: ¡Libera tu ordenador/móvil con nosotros! ¡Campaña por el fin de Windows 10! – nueva charla organizada por GNU/Linux València


La entrada Gaming en Linux + taller de ayuda e instalación, nuevo evento organizado por GNU/Linux València se publicó primero en KDE Blog.
Tumbleweed – Review of the week 2026/43
Dear Tumbleweed users and hackers,
This week saw the release of 5 snapshots (1016, 1017, 1018, 1020, and 1021).
Big desktop milestones and unblocked migrations took center stage across Tumbleweed this week. However, the biggest headlines in the broader tech landscape revolved around security—specifically the critical remote code execution vulnerabilities in PHP dubbed “PHP2Shell” (CVE-2026-109618 and CVE-2026-109619). Tumbleweed users were protected promptly when snapshot 1021 delivered PHP 8.5.12 addressing both flaws. Security was a prominent theme across other snapshots as well: snapshot 1016 rolled out curl 8.23.0 with multiple CVE fixes, snapshot 1020 brought Mozilla Firefox 158.0, and polkit 128 arrived to fix authentication-helper vulnerabilities while dropping previous temporary service memory caps.
Alongside security responses, major desktop and foundational transitions landed. Snapshot 1016 delivered KDE Plasma 6.8.0, accompanied by swift packaging adjustments in SDDM and the lockscreen footer to ensure smooth logins and proper virtual keyboard behavior. Complementing the desktop, snapshot 1018 rolled out both Qt 6.12.0 and Mesa 26.2.5. Snapshot 1018 also marked the completion of the containerd 2.x migration, shipping containerd 2.3.3 after an update to open-vm-tools resolved the build conflict tracked in boo#1284086.
Under the hood, Linux Kernel stepped up to 7.2.11 in snapshot 1017. Other notable deliveries included systemd 261.4, CUPS 2.4.20 (fixing an upstream mailto notification regression), SQLite 3.54.1, LVM2 2.03.43, and Memtest86+ 9.00, which adds native AArch64 (ARM64) support and Secure Boot signing.
These 5 snapshots delivered the following updates:
- 7zip 26.04
- containerd 2.3.3
- cups 2.4.20
- curl 8.23.0
- freetype2 2.15.0
- gedit 51.0
- GraphicsMagick 1.3.49
- KDE Plasma 6.8.0
- libaom 3.15.2
- Linux Kernel 7.2.11
- lvm2 2.03.43
- memtest86+ 9.00
- Mesa 26.2.5
- MozillaFirefox 158.0
- ntfs-3g_ntfsprogs 2026.9.28
- os-prober 1.85
- php8 8.5.12
- pipewire 1.6.9
- polkit 128
- poppler 26.10.0
- Qt 6.12.0
- sqlite3 3.54.1
- systemd 261.4
- tmux 3.8
- vim 9.2.1202
As we turn our focus to the upcoming days, here is a preview of what is currently making its way through the staging projects:
- GNOME 51.1: A comprehensive update across GNOME Shell, Mutter, and core desktop applications is currently undergoing integration testing.
- Linux Kernel 7.3.0
- Ollama 0.40.9
- HarfBuzz 15.0.0
- Ruby 4.0.9: Addressing multiple upstream regular expression CVEs.
- Go 1.27.3
- VirtualBox 7.2.22
- fmt 12.2.0
- kernel-source-longterm 6.18.55: Waiting on VirtualBox driver updates to adapt to kernel API changes.
- Swig 4.5.0: YaST integration issues remain under investigation, tracked under boo#1275515.
Publicado Agama 25
Esta nueva versión del nuevo instalador de openSUSE/SUSE es la primera versión después de openSUSE Leap 16.1, iniciando el trabajo hacia Tumbleweed, Slowroll y Leap 16.2.

Agama 25, el nuevo instalador de openSUSE y SUSE ya está aquí, y aunque no incluye ninguna función destacada en particular, si incluye algunos cambios solicitados por los usuarios y una preparación para allanar el camino para próximos lanzamientos tanto Leap, como Tumbleweed, o Slowroll
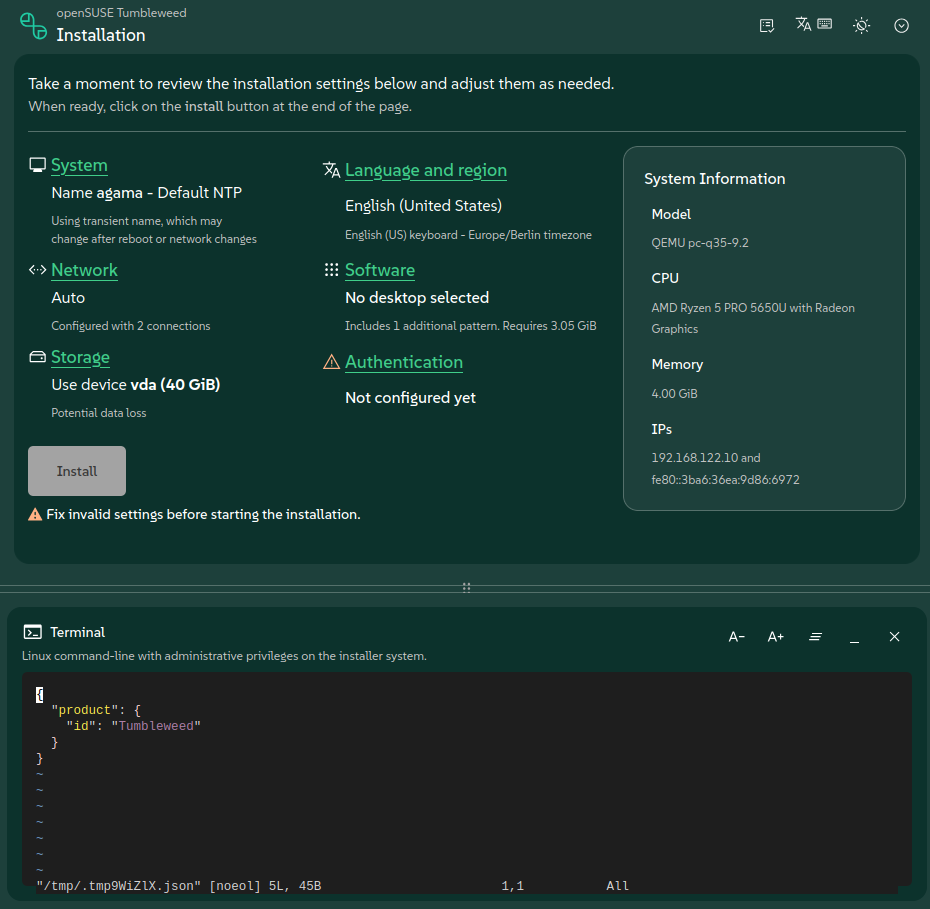
Una terminal integrada en el entorno web del instalador
La interfaz web de Agama hasta ahora contaba con un terminal real, ees decir que si necesitabas una shell en el sistema que estabas instalando, tus opciones se limitaban a cambiar a otra consola virtual (por ejemplo, Ctrl+Alt+F8) si tenías acceso local, o conectarte por SSH.
Desde esta nueva versión puedes abrir un terminal desde la comodidad de la interfaz web de Agama, sin salir del navegador, lo que facilita muchas tareas y puede resultar muy útil el poder acceder a una terminal de manera nativa desde el propio instalador.
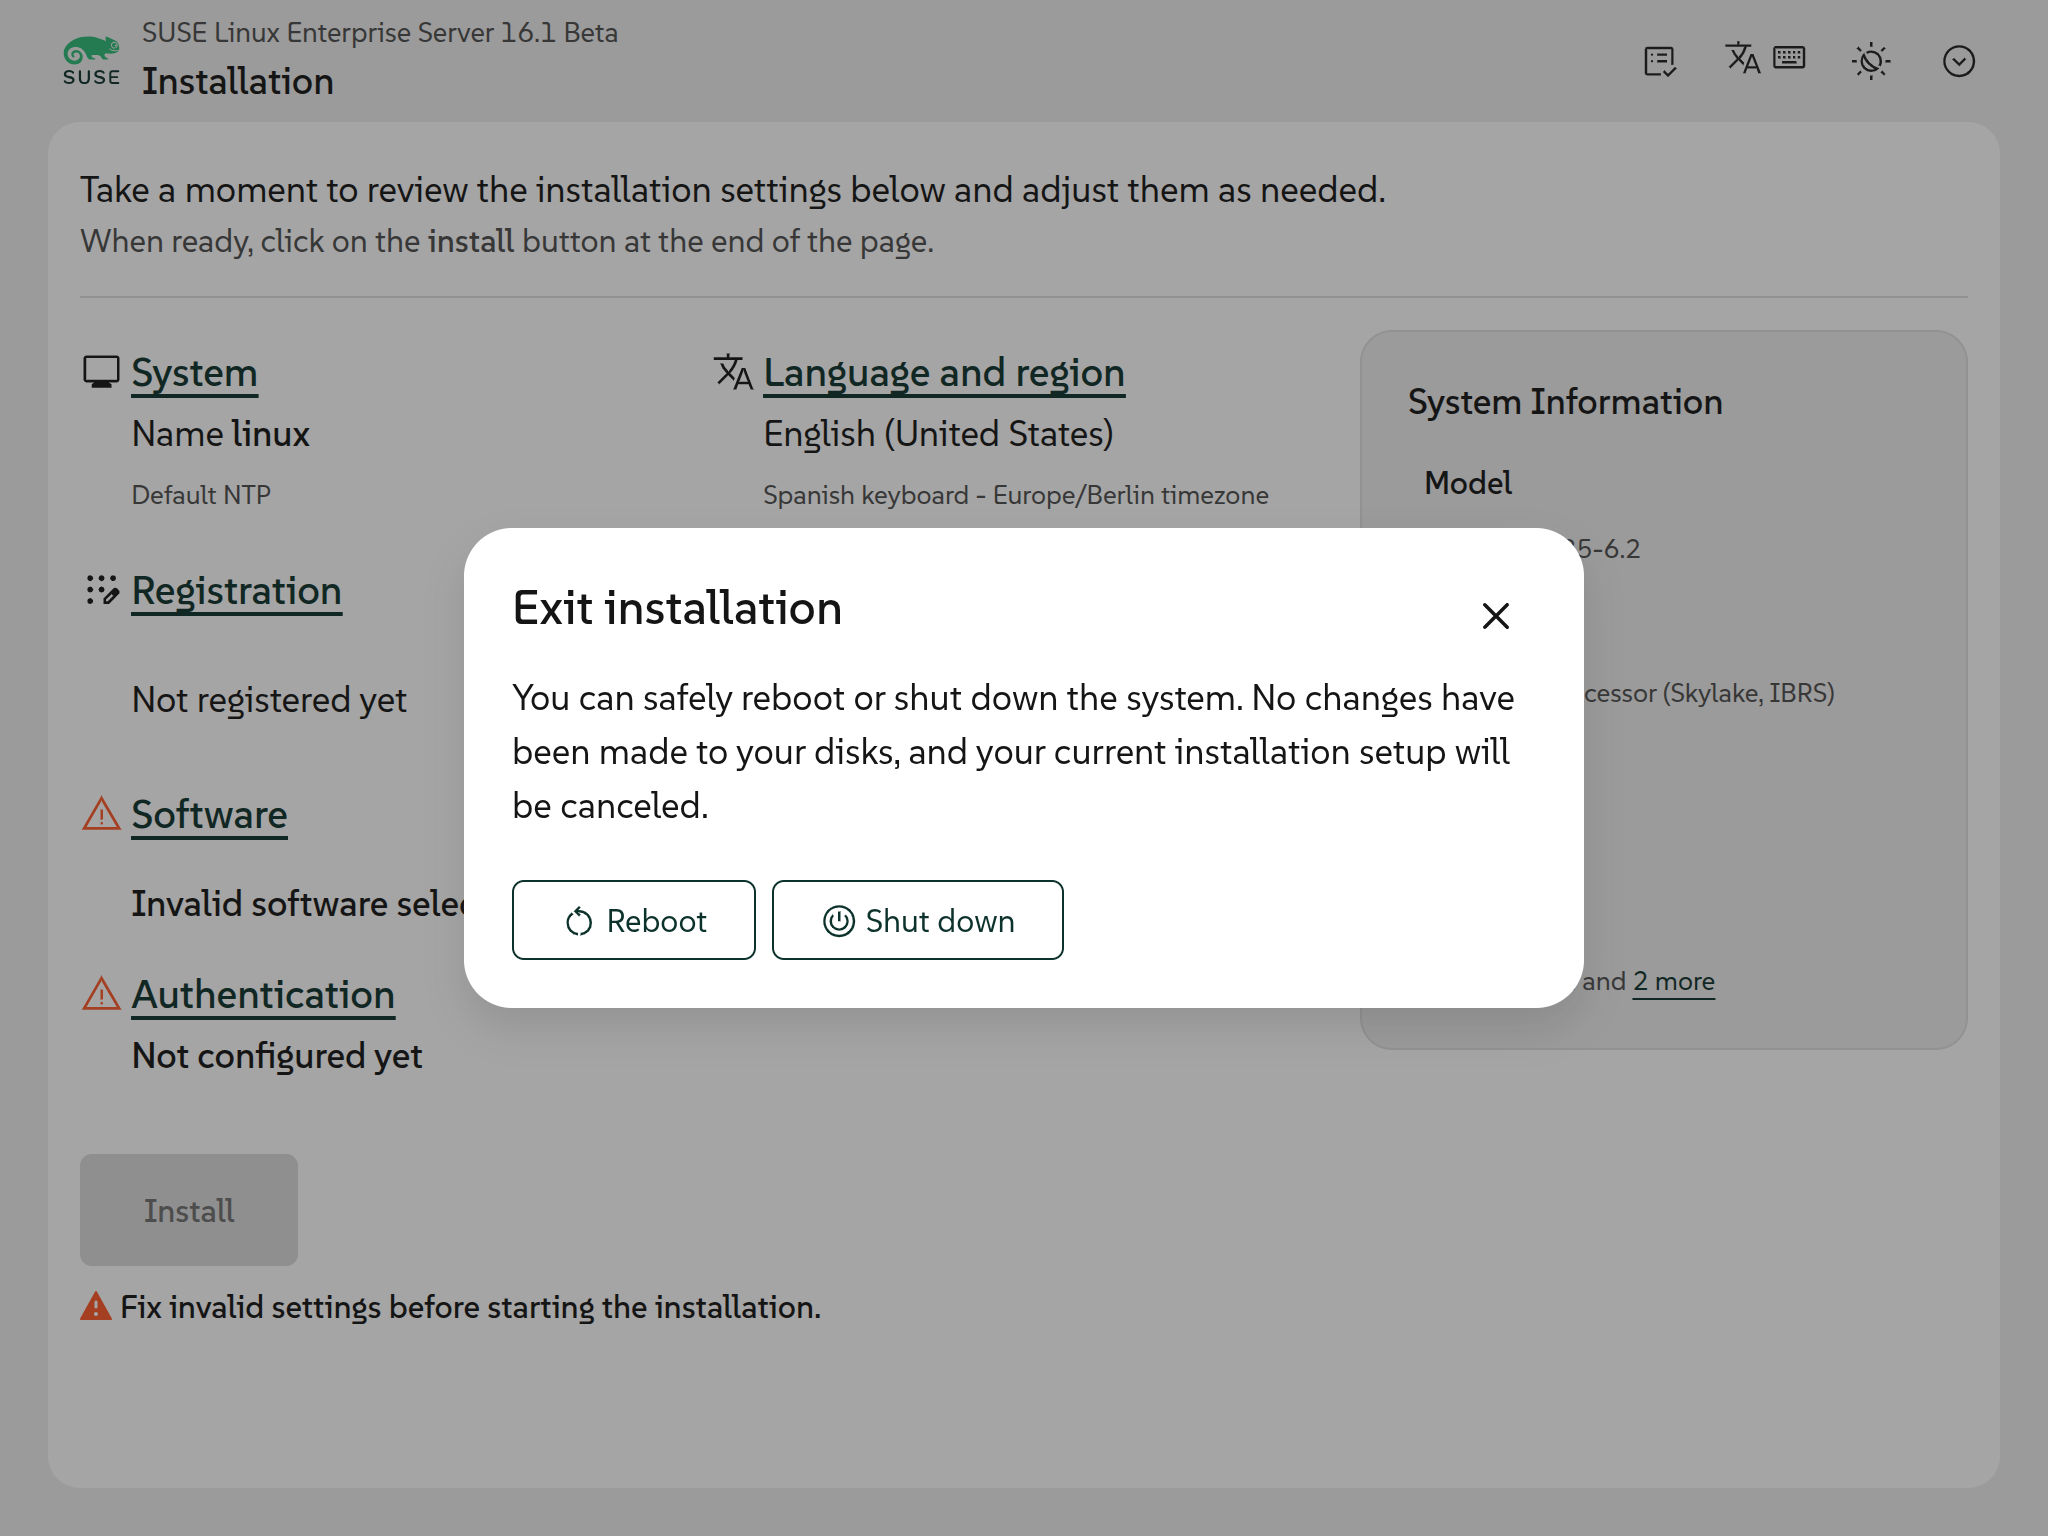
Poder abandonar el proceso antes de que sea demasiado tarde
Algo que ha sido solicitado por varios usuarios, es que ahora Agama ofrece una opción de interrumpir el proceso. La encontrarás desde el principio del proceso, permitiéndote reiniciar o apagar la máquina si cambias de opinión.
Es importante señalar que la opción solo está disponible antes de que comience la instalación: cancelar mientras Agama ya está aplicando cambios al sistema podría dejarlo en un estado impredecible y potencialmente no arrancable, por lo que la opción de abandonar el proceso desaparece tan pronto como la instalación ya está ha comenzado.
Con la vista puesta en Tumbleweed
Los desarrolladores siguen trabajando con los responsables de Tumbleweed para que Agama sea el instalador de la distribución. Aún no hay una fecha fijada, pero poco a poco se va trabajando con ese objetivo. Así que a término y en un tiempo que ahora no se puede definir, también Agama tomará el control a la hora de instalar Tumbleweed en tu equipo, y junto con Tumbleweed también Slowroll.
Cortando poco a poco lazos con YaST
Agama nació sobre la base de varios paquetes del instalador YaST, reutilizando lógica que ya existía en lugar de reescribirla desde cero. Pero poco a poco se está reduciendo esa dependencia, incorporando a la propia base de código de Agama solo las partes que realmente necesita en lugar de incorporar módulos completos de YaST. Hasta ahora este esfuerzo cubre el código relacionado con AutoYaST, y seguirán más áreas.
El antiguo instalador YaST ya es un proyecto abandonado, ya que nadie ya se hace cargo de mejoras, a su código y se irán eliminado partes de código cuando este vaya bloqueando otros procesos que por su culpa no puedan evolucionar.
El instalador YaST ha muerto, larga vida a Agama.
Enlaces de interés
Planet News Roundup
This is a roundup of articles from the openSUSE community listed on planet.opensuse.org. This community blog feed aggregator lists the featured highlights below from Oct. 16 - 22.
This week highlights seven Tumbleweed snapshots for week 42 headlined by Linux Kernel 7.2.10, KDE Gear 26.08.2 and Mozilla Firefox 157.0.1, the first Plasma 6.8 update and the seventh Plasma 6.6 update, Tellico’s 25th anniversary, the KDE documentary, Agama 25, the Akademy-es 2026 Madrid program and preview, a report from the openSUSE.Asia Summit and Open Source Summit Europe, September Kudos, a deep look at vllm.cpp and more.
Here is a summary and links for each post:
Akademy-es 2026 Madrid 20th Anniversary Begins Tomorrow
The KDE Blog reminds readers that Akademy-es 2026 Madrid kicks off tomorrow, Oct. 23, and runs through Oct. 25 at Camping Arco Iris in Villaviciosa de Odón. Baltasar Ortega recaps the build-up, including the talk program, gold sponsor openSUSE, silver sponsor Slimbook, registration and 10 reasons to attend. He notes he cannot attend in person this year and will live vicariously through the photos and updates from Madrid.
Building syslog-ng with bundled ivykis on FreeBSD
Peter Czanik’s blog explains that the syslog-ng FreeBSD port currently uses ivykis from ports, even though the project carries FreeBSD-specific fixes in its own ivykis fork. He is working on making the bundled ivykis selectable and invites testing and help.
VLLM.CPP: A New Engine Is Born
Alessandro’s blog examines vllm.cpp, LocalAI’s C++20 inference engine that brings vLLM-style continuous batching, paged KV caching and an OpenAI-compatible server without requiring Python or PyTorch inside the engine. It compares the project with vLLM and llama.cpp, reviews its C API, formats and hardware backends, and cautions that multi-GPU support, multimodal input and some KV-cache features remain incomplete.
First Plasma 6.8 Update
The KDE Blog announces Plasma 6.8.1, the first bugfix update to Plasma 6.8, released on Oct. 20, 2026. It recaps the 6.8 highlights, including the Hanabi wallpaper, Nepali calendar support, GTK4 decoration fixes, Discover’s AppStream previews and the redesigned Flatpak permissions page.
Releasing Agama 25
The Agama Installer announces Agama 25, the first release after openSUSE Leap 16.1 and the start of work toward Tumbleweed, Slowroll and Leap 16.2. It adds a web-based terminal, an exit option available before installation begins, searchable multi-select bond and bridge port selection, riscv64 support contributed by Andreas Schwab, and reduced reliance on YaST packages. It also publishes the OpenAPI specification and JSON schemas at stable URLs for autocompletion and validation in editors.
Seventh Plasma 6.6 Update
The KDE Blog covers Plasma 6.6.7, released Oct. 16, 2026, as the seventh maintenance update in the 6.6 series. It notes that the series has received extra updates through an agreement with KUbuntu Focus and lists 6.6 features such as Plasma Keyboard, OCR in Spectacle, Plasma Setup, custom global themes and colorblind filters.
Budapest Audio Expo 2026
Peter Czanik’s blog reports on the third Budapest Audio Expo, where his favorite room paired NCS Audio, Qualiton and Pixel cables for a clear, lively sound at a relatively affordable price. He also praises 72 Audio, the Natural Distortion prototype DAC and amp with Popori Acoustics speakers, and a Heed Audio Helikon and Zellaton setup, while criticizing overprocessed room-correction demos.
September Kudos, Recognition
openSUSE News publishes the September Kudos report, noting that 14 users received 14 kudos and 152 badges were awarded to 136 contributors. It lists thank-you notes for contributors such as Adrian Schröter, Bernhard Wiedemann, Dominique Leuenberger and Santiago Zarate, and highlights Tumbleweed, Leap 16.0/16.1 and LinuxDays badges.
New Weather Widget and On-Screen Keyboard – This Week in Plasma
The KDE Blog translates Nate Graham’s latest “This Week in Plasma,” covering the new Plasma 6.9 weather widget with hourly forecasts and Open-Meteo support, a redesigned on-screen keyboard, a temporary night-light toggle and smaller tray icons. It also covers Plasma 6.8.1 fixes, clipboard shortcut reorganization and Qt 6.13 font hinting improvements.
Tellico Turns 25 – Long Live Tellico!
The KDE Blog celebrates Tellico’s 25th anniversary with a timeline from the first Bookcase 0.1 release in November 2001 through its renaming to Tellico, its move to KDE Extragear and the Qt6/KDE Frameworks 6-based Tellico 4.0. The post also explains how the collection manager works and highlights its customizable fields and built-in collection types.
Linux Saloon 224 | Open Mic Night
Nathan Wolf hosts Linux Saloon 224 as an open mic night, where Mike Chilson demonstrated DevsFTP and discussed backup solutions. Participants shared their Linux experiences, and the show invites community suggestions for future application topics.
On GenAI LLMs and Knowledge Workers
Santiago Zarate reflects on how LLMs and agents may reshape knowledge work, starting from a Telegram poll of Venezuelan programmers about whether the future remains human. He compares the change to spreadsheets, factory robots and automated telephone exchanges, argues that automation changes jobs more than it eliminates them, and urges readers not to panic while warning that developers still need real fundamentals.
Tumbleweed – Review of the Week 2026/42
Dominique Leuenberger and Victorhck detail the seven snapshots and major arrivals such as libvirt 12.8.0, libnettle 4.0, KDE Gear 26.08.2, WebKitGTK 2.54.1, GStreamer 1.28.8 and Nautilus 50.4. They also explain the mutter revert that restored clipboard copy and paste, the ktextaddons ABI fix and the cups-filters hardening, and previews staging work on Plasma 6.8.0, Qt 6.12.0 and more.
The KDE Documentary
Martin Schlander’s blog recommends the KDE 30th-anniversary documentary, calling it a high-quality production that covers the project’s most significant events. He notes that it also touches on Qt, GNU, Linux and GNOME and features legendary SUSE developers.
Akademy-es 2026 Madrid 20th Anniversary Talk Program #akademyes
The KDE Blog shares the talk program for Akademy-es 2026, taking place Oct. 23-24 at Camping Arco Iris in Villaviciosa de Odón, Madrid. The 20th-anniversary event includes a QML workshop, talks on KDE España, Plasma and low vision, Okular, Autofirma on Flathub, data-center sustainability and plenty of time for socializing.
Liberec Dam
Jakub Steiner shares a drone video of the restored Harcovská přehrada dam in Liberec, Czechia, after a major reconstruction that removed 26,000 cubic meters of silt and replaced the dam’s outlets while preserving its landmark appearance. He also recalls filming the drained basin in 2022, notes the dam is now rated for a 10,000-year flood, and admits the dam has claimed another one of his drones.
KDE Documentary: A History of the Underdogs of Free Software
The KDE Blog highlights CultRepo’s KDE documentary, “A History of the Underdogs of Free Software,” which premiered on Oct. 14 for KDE’s 30th anniversary. The film traces KDE from Matthias Ettrich’s 1996 Usenet post through the Qt licensing struggle, the KHTML-to-WebKit story, the KDE 4 controversy and the community’s role in today’s Linux desktops.
From Yogyakarta to Prague: openSUSE.Asia Summit and Open Source Summit Europe 2026
openSUSE News reports on a two-continent trip to the openSUSE.Asia Summit in Yogyakarta and Open Source Summit Europe in Prague. The post covers the Asia summit’s community news, quiz, offsite turtle release and batik workshop, the adoption of Kudos, a new 14:00 CEST Tuesday meeting time, and a busy Prague booth featuring a 64-core RISC-V workstation running Tumbleweed and QtRvSim.
View more blogs or learn to publish your own on planet.opensuse.org.
Mañana empieza Akademy-es 2026 de Madrid Edición 20 aniversario
Ya queda nada. Del 23 al 25 de octubre, es decir, mañana empieza Akademy-es 2026 de Madrid Edición 20 aniversario el esperado encuentro organizado por KDE España para todos los simpatizantes del proyecto que este año será más comunitario que nunca dado que se realiza en un Camping. Y ya que escribo esta entrada y los comparto con vosotros, os animo a hacer los mismo con vuestro allegados y redes sociales.
Mañana empieza Akademy-es 2026 de Madrid Edición 20 aniversario
Como sabrán los lector del blog del 23 al 25 de octubre se va a celebrar Akademy-es 2026 de Madrid el evento más importante para los desarrolladores y simpatizantes de KDE, organizado por KDE España.
A lo largo de muchas entradas he hablado de patrocinadores, colaboradores, sede, programa, las razones para ir al evento… es decir, he promocionado lo que he podido Akademy-es 206 por su importancia dentro de la Comunidad Kdeera, por ser un momento dinamizador de la asociación.
A modo de resumen os comento qu, entre otras cosas hemos:
- Publicado el programa de charlas.
- Hablado del patrocinador oro, OpenSUSE
- Y del patrocinador plata, Slimbook.
- Animado a registrarse.
- Comentado 10 motivos para asistir.
- Animado para presentar una charla.
- Anunciado el evento.
En definitiva, aunque este año no puedo participar de forma presencial ni tampoco encargarme apenas de la organización, creo que desde el blog hemos promocionado suficientemente el evento.
Esperemos que el año que viene podamos hacerlo mejor, participar de forma más activa y, sobre todo, asistir porque me voy a morir de envidia este fin de semana.
Solo queda esperar las novedades, fotografías y momentos que nos lleguen desde Madrid, y hacer un poco de caja de resonancia de las mismas.
La entrada Mañana empieza Akademy-es 2026 de Madrid Edición 20 aniversario se publicó primero en KDE Blog.
Building syslog-ng with bundled ivykis on FreeBSD
One of the core dependencies of syslog-ng is the ivykis library. We have a few FreeBSD specific fixes in our ivykis fork, however the syslog-ng port uses ivykis from ports instead of the bundled version. I am now working on making it selectable. Testing and help are welcome.
Read more at https://www.syslog-ng.com/community/b/blog/posts/building-syslog-ng-with-bundled-ivykis-on-freebsd
syslog-ng logo
VLLM.CPP: Nascendo um novo motor.
Arquitetura vantagens e limitações diante de llama cpp e vLLM
Pesquisa em 22 de outubro de 2026
O vllm.cpp procura reunir a distribuição de um motor nativo com mecanismos de atendimento concorrente inspirados no vLLM. Seu benefício mais claro é executar inferência sem um ambiente Python ou PyTorch dentro do motor. O projeto oferece recursos relevantes de escalonamento e cache, este texto é baseado no github oficial.
O que é o projeto e quem o mantém
Apresentado pela equipe do LocalAI e associado a Ettore Di Giacinto, o vllm.cpp é um motor de inferência desenvolvido em C++20. Ele carrega pesos já treinados e executa os cálculos necessários para produzir respostas. Pode funcionar como biblioteca incorporada a outra aplicação, ferramenta de terminal ou servidor HTTP. O repositório atual está em localai-org/vllm.cpp; endereços antigos sob mudler/vllm.cpp redirecionam para ele. [1]
O projeto é independente e não recebe endosso do vLLM oficial. A licença do código é Apache 2.0; os modelos mantêm suas próprias licenças. Seu objetivo inclui reproduzir comportamentos do vLLM, mas isso não equivale a compatibilidade completa com todas as suas versões, modelos, extensões ou configurações. [1, 4]
Como a arquitetura atende várias requisições
Em uma conversa com um modelo há duas etapas importantes. No prefill, o motor processa o texto de entrada. No decode, produz a continuação, normalmente um token por etapa. O escalonador decide quais requisições entram em cada rodada e como compartilhar a capacidade disponível. Separar essas etapas ajuda a entender por que um programa pode responder rapidamente a uma pessoa e ainda se comportar mal com muitas pessoas simultâneas.
O vllm.cpp implementa continuous batching, prefill em partes, preempção e reutilização de prefixos. Com continuous batching, novas requisições podem entrar à medida que outras terminam, sem esperar o lote inteiro acabar. Por exemplo, uma resposta curta pode liberar espaço para uma nova conversa enquanto outra resposta longa continua. O benefício depende da carga e dos kernels que realmente executam o modelo. [4]
O KV cache paginado armazena os estados de atenção em blocos administrados pelo motor. A técnica reduz desperdícios de alocação e permite compartilhar blocos quando há prefixos compatíveis. Ela atua sobre a memória usada pelo contexto; não comprime automaticamente os pesos do modelo. O trabalho original sobre PagedAttention explica essa relação entre fragmentação, compartilhamento e capacidade de agrupar requisições. [5]
O projeto também expõe políticas inspiradas no SGLang. A opção chamada RadixAttention é um alias para o cache automático de prefixos por hash do próprio motor; a documentação esclarece que não existe um caminho separado com uma árvore radix. A política LPM prioriza requisições com o maior prefixo já disponível no cache e depende desse cache estar habilitado. Essa escolha pode evitar trabalho repetido em aplicações com um prompt de sistema compartilhado. [6]
Biblioteca formatos e compatibilidade
A interface C pública, em include/vllm.h, permite vinculação estática ou dinâmica e integração por FFI. Na consulta realizada, a ABI estava na versão 30, consultável por vllm_abi_version(). Isso facilita incorporar o motor a programas escritos em C, C++, Go ou Rust. A ABI tem regras explícitas de evolução; internamente, os comandos e o servidor continuam mudando rapidamente. [2]
O servidor oferece /v1/chat/completions, /v1/completions, streaming, /metrics e tokenização. Endpoints para embeddings e áudio dependem da arquitetura e dos callbacks carregados. A API compatível com OpenAI facilita reutilizar clientes, mas seus recursos precisam ser confirmados. Até /health indica apenas que o processo está vivo, sem comprovar uma primeira geração concluída. [7]
Os formatos centrais são Safetensors e GGUF, com caminhos para NVFP4, FP8 e famílias GGUF. A compatibilidade depende da arquitetura, do layout dos tensores, da quantização e do backend. Aceitar um formato em uma família não garante que qualquer checkpoint com esse rótulo execute em outra. A documentação, por exemplo, ainda recusa GGUF TQ1_0 e TQ2_0, apesar da existência de kernels ternários. [8]
A decodificação especulativa inclui MTP, DFlash e caminhos com n-gramas, com diferentes níveis de validação. O documento também distingue métodos aceitos no JSON de métodos que realmente executam: draft_model tem configuração reconhecida, mas a carga é recusada por faltar o caminho de execução. Ganhos dependem do modelo, da taxa de aceitação e da carga; a existência de uma opção não demonstra aceleração em qualquer cenário. [9]
Hardware e distribuição
O motor textual usa seu próprio runtime de tensores. A compilação utiliza CMake e um compilador C++20; o servidor usa cpp-httplib. Há backends CPU, CUDA, Metal e Vulkan, com cobertura que varia por operação e modelo. No caminho CUDA, alguns kernels Triton já são distribuídos como código previamente compilado: Python e Triton são necessários para regenerá-los, não para executar esses binários. Os drivers e as dependências do backend continuam necessários. [10]
| Ambiente | Situação documentada e consequência |
| CPU x86 e Arm | Há caminhos nativos e seleção de instruções. Velocidade deve ser medida no processador e no modelo escolhidos. |
| NVIDIA CUDA | A referência principal de medição é o GB10. Compilar para outra arquitetura CUDA não comprova o mesmo desempenho. |
| Apple Metal e Vulkan | Há implementações, mas a cobertura e a validação variam entre operações e modelos. |
| AMD ROCm | Há execuções nativas em caminhos específicos; permanecem lacunas de correção e de validação entre dispositivos. |
| Intel XPU e NPU | Não há base documental para prometer aceleração Intel NPU pronta. A matriz ainda indica lacunas nos backends XPU. |
Fontes da matriz: guias de compilação e ROCm e matriz de funcionalidades. Suporte por Vulkan a uma GPU não implica suporte à NPU do mesmo fabricante. [4, 10, 11]
A release publicada mais recente encontrada foi a v0.0.2, de 11 de agosto de 2026. Seus arquivos para Linux e macOS possuem classificações distintas, incluindo stable e preview. Recursos descritos na branch principal em outubro podem não estar nesse pacote de agosto. Os arquivos também têm exigências de ABI do sistema e arquitetura do dispositivo; um executável pequeno não é automaticamente portátil para qualquer distribuição Linux ou GPU. [12, 13]
O que os números publicados demonstram
Os resultados abaixo foram publicados pelos mantenedores e constituem evidência documental, sem execução de novos benchmarks nesta análise. A principal ressalva está no próprio protocolo: várias comparações foram feitas contra uma referência anterior do vLLM e aguardam repetição após a mudança da referência em setembro. As séries identificadas como vLLM 0.25.0 são marcadas como superadas. Portanto, resultados históricos não comprovam paridade com a versão atual. [3]
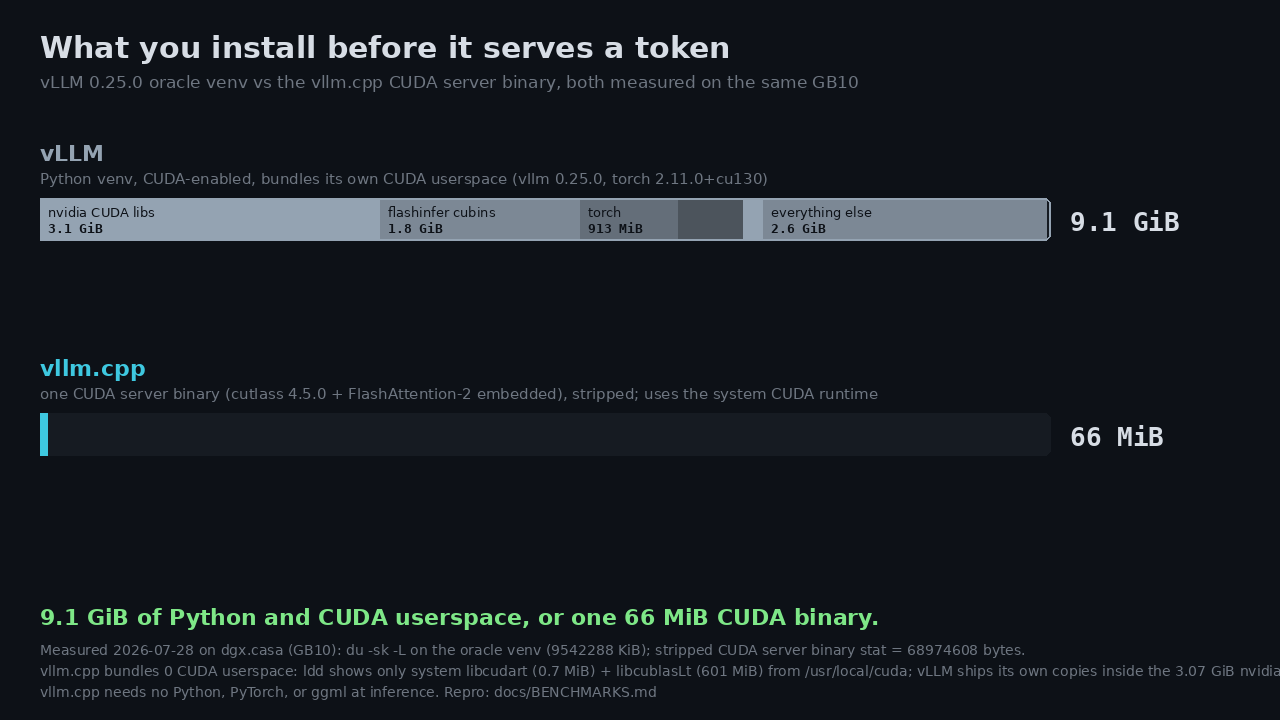
O anúncio de aproximadamente 140 vezes menos para instalar compara um binário de 66 MiB com uma instalação de 9,1 GiB, medidos no ambiente usado pelo projeto. A ordem de grandeza é relevante para distribuição, mas não representa uma redução de 140 vezes na RAM, na VRAM ou na memória necessária aos pesos. Contêineres, modelos e drivers também não cabem automaticamente nesses 66 MiB. [1, 13]
| Métrica publicada | vllm.cpp | vLLM | Como interpretar |
| Pico de PSS | 24,88 GiB | 28,18 GiB | Aproximadamente 11,7% menos no ensaio. |
| Pico de RSS | 24,88 GiB | 28,56 GiB | Outra medida de memória residente; não somar à PSS. |
| Queda de MemAvailable | 68,35 GiB | 80,66 GiB | Variação da memória disponível do sistema naquele ensaio. |
A tabela de memória refere-se ao Qwen3.6-27B NVFP4 no GB10, durante a janela de atendimento. O GB10 usa memória unificada: números de memória do processo e do dispositivo não devem ser somados como se fossem RAM e VRAM fisicamente independentes. Os valores demonstram uma economia naquele teste, sem estabelecer uma porcentagem universal. [3, 14]
O relatório detalhado de atendimento também preserva um contraexemplo: para outro checkpoint/caminho do Qwen3.6-27B, registra pico de RSS de 21,10 GiB no vllm.cpp e 13,09 GiB no vLLM. São medições históricas de configurações distintas da tabela anterior. Elas mostram por que a retirada do Python, isoladamente, não garante menor uso de memória em todos os modelos. [15]
Na série histórica do Qwen3.6-27B NVFP4 da Unsloth, o projeto publicou 86,05 contra 82,32 tokens totais por segundo com uma requisição, e tratou as demais concorrências como empates. Esses tokens totais incluem entrada e saída; não são 86 tokens gerados por segundo. O relatório específico também contém resultados abaixo do vLLM para outros checkpoints e cargas. Como as referências mudaram, a leitura correta é que houve cenários competitivos, sem evidência de vitória geral ou atual. [3, 15]
A comparação com llama.cpp exige ainda mais cautela. O relatório de CPU informa que um denominador usado era um fork local com alterações de desempenho e pede nova medição contra o upstream fixado. Há também séries antigas em que vllm.cpp perde. A página diz expressamente que não mediu atendimento concorrente contra o servidor llama.cpp naquele ensaio. Assim, não há fundamento para transformar a antiga alegação de ganho no prefill em superioridade geral. [16]
Um levantamento exploratório em AMD Strix Halo torna a limitação mais concreta: com Qwen3.8-27B Q4_K_M, publicou 12,219 tok/s de decode para llama.cpp, 11,056 tok/s derivados para vLLM e 5,397 tok/s derivados para vllm.cpp. O próprio estudo não certifica a comparação: a verificação de tokens não passou, houve sessões distintas e parte das taxas foi inferida de tempos com dois comprimentos de saída. Ele documenta uma observação localizada desfavorável ao vllm.cpp, não um ranking reproduzido para todo hardware. [17]
Vantagens e desvantagens diante do vLLM
A principal vantagem é operacional. Distribuir e incorporar uma biblioteca nativa pode simplificar imagens de sistema, instaladores e aplicações que já são escritas em C ou C++. Também reduz a necessidade de manter um ambiente Python/PyTorch dentro do motor. Essa simplificação tem valor mesmo quando a taxa de geração empata. O ganho deve ser avaliado pelo pacote completo utilizado, inclusive bibliotecas e serviços externos. [2, 10, 13]
O carregamento direto de Safetensors e GGUF é outro atrativo para quem trabalha com os dois ecossistemas. É preciso, porém, corrigir uma comparação frequente: o vLLM também aceita GGUF. Sua documentação atual encaminha esse suporte ao vllm-gguf-plugin e o classifica como experimental e pouco otimizado. A diferença está na integração e na cobertura dos caminhos de execução, não na exclusividade do formato. [8, 18]
A desvantagem mais forte aparece na escala. O vllm.cpp descreve sua situação como single-GPU; o paralelismo de tensores possui trabalho e testes parciais, sem validação completa em duas GPUs na matriz consultada. Paralelismo de pipeline, de especialistas e execução multinó continuam incompletos. O vLLM documenta estratégias de tensor e pipeline parallelism para uma ou várias máquinas, o que o torna a escolha mais sustentada pela documentação para esses requisitos. [4, 19]
O vLLM também possui um ecossistema de implantação e uma arquitetura com servidor de API, núcleo do motor e workers. Essa organização traz componentes a operar, mas serve a necessidades de concorrência e distribuição. Descrever o vLLM apenas como Python lento seria incorreto: os cálculos pesados usam kernels especializados. A troca de linguagem da coordenação não determina, sozinha, a velocidade da GPU. O vLLM atual também documenta CPU, NVIDIA, AMD, Intel XPU e Apple Silicon, com diferentes mecanismos de suporte. [20, 21]
Vantagens e desvantagens diante do llama cpp
O atrativo do vllm.cpp é reunir Safetensors e uma arquitetura de atendimento inspirada no vLLM dentro de uma biblioteca nativa. Um serviço com muitas requisições e prefixos repetidos pode se beneficiar dessas escolhas, se o modelo e o backend necessários estiverem bem implementados. Isso é uma hipótese técnica para testar, e não uma vantagem de throughput já demonstrada contra llama.cpp em todas as situações. [2, 6, 16]
O llama.cpp já oferece execução nativa, quantizações, ampla variedade de backends e inferência híbrida CPU/GPU. Seu servidor documenta múltiplos usuários, continuous batching, cache, ferramentas, saídas estruturadas e decodificação especulativa. Portanto, a comparação não deve partir da ideia de que ele atende apenas uma pessoa ou carece de batching. O interesse está em comparar a eficiência e o comportamento dessas implementações na carga real. [22, 23]
Para máquinas pessoais, GGUF e combinações de CPU/GPU, a cobertura publicada do llama.cpp costuma oferecer um ponto de partida mais abrangente. O vllm.cpp precisa demonstrar um benefício concreto que compense a migração e as lacunas do caminho escolhido. Além disso, chamar a biblioteca nativa de diferencial exclusivo seria incorreto: ambos têm essa característica. As licenças do código são distintas, Apache 2.0 no vllm.cpp e MIT no llama.cpp. [1, 22, 24]
Limitações que influenciam a adoção
Algumas limitações ficam mais claras nos documentos específicos do que na apresentação do repositório. Elas devem orientar a escolha dos recursos:
Jump-forward. A opção existe e é validada, mas não tem chamador na execução de produção. Habilitá-la não acelera requisições no estado documentado. [6]
KV externo. O cliente C++ de LMCache possui caminho documentado de execução. O OffloadingConnector local para CPU/disco ainda não possui a parte que transfere os dados para as páginas do motor e, por isso, sua utilização é recusada. O servidor externo LMCache pode continuar exigindo seu próprio ambiente Python. [25]
Multimodalidade. No HTTP, o guia distingue Qwen3-VL e dots3-note, com testes de integração em CPU usando pesos sintéticos. Imagens exigem RGB bruto no caminho descrito; PNG, JPEG e entrada de vídeo são recusados. Registrar uma arquitetura multimodal não demonstra que todas as formas de entrada, interfaces ou aceleradores foram validados. [26]
Integrações incompletas. A matriz registra LoRA ainda sem uso completo pelo servidor. Recursos podem ter código, configuração ou testes locais sem uma execução completa acessível ao usuário. A evolução da branch principal também exige fixar uma versão ou commit e validar novamente após mudanças. [1, 4]
Como escolher e testar
| Necessidade | Ponto de partida sugerido |
| GGUF local e combinação de CPU e GPU | llama.cpp, pela cobertura publicada; confirmar o modelo e o backend. |
| Múltiplas GPUs ou máquinas | vLLM, pelos caminhos documentados de paralelismo e implantação. |
| Biblioteca C++ com atendimento no estilo vLLM | vllm.cpp como candidato a avaliação, fixando o commit e os recursos necessários. |
| Maior desempenho ou menor memória | Medir os três na mesma máquina e na mesma carga; o nome do projeto não decide. |
Essas sugestões são uma interpretação técnica da cobertura e dos limites descritos nas fontes, não resultados de um novo ensaio. Um teste útil mantém o mesmo checkpoint e quantização, template de conversa, modo de raciocínio, número de tokens de entrada e saída, dtype do KV cache e regras de parada. Deve testar separadamente cache frio, cache aquecido e concorrências representativas.
As métricas que permitem decidir são tempo até o primeiro token, tempo entre tokens, tokens de saída por segundo, latência completa, percentis p95/p99, falhas e consumo de memória do conjunto de processos. PSS, RSS, memória do dispositivo e memória disponível do sistema medem coisas diferentes. A utilização de CPU também precisa ser medida: a ausência de Python não comprova, por si só, menos trabalho de CPU, menor energia ou melhor throughput.
O vllm.cpp merece avaliação quando a distribuição nativa e a incorporação ao produto são prioridades. Uma adoção pode se justificar por manutenção e integração, mesmo com desempenho semelhante. Para substituir um serviço existente, o critério deve ser um resultado reproduzido no modelo, hardware e nível de concorrência da aplicação, com os recursos necessários funcionando de ponta a ponta.
Fontes primárias
Consulta em 22 de outubro de 2026. Os documentos do vllm.cpp abaixo apontam para o retrato consultado do repositório, commit 845b3c59d43d1da2583efa738b9ec9f715ba2312. As datas e referências dos benchmarks são as dos respectivos ensaios, que podem ser anteriores a esse commit. As páginas dos outros projetos refletem a documentação pública consultada na data da pesquisa.
[1] vllm.cpp — apresentação autoria licença e aviso de desenvolvimento
[2] vllm.cpp — interface C e versão da ABI
[3] vllm.cpp — protocolo referências superadas e medições pendentes
[4] vllm.cpp — funcionalidades cobertura e limitações
[5] Kwon e colaboradores — PagedAttention e gestão do KV cache
[6] vllm.cpp — políticas inspiradas no SGLang e jump-forward
[7] vllm.cpp — servidor rotas e comportamento das APIs
[8] vllm.cpp — uso formatos quantizados e tamanho do contexto
[9] vllm.cpp — métodos e limites da decodificação especulativa
[10] vllm.cpp — compilação dependências e backends
[11] vllm.cpp — guia e limites do backend ROCm
[12] vllm.cpp — releases e arquivos publicados
[13] vllm.cpp — distribuição binária e dependências externas
[14] vllm.cpp — medições de memória
[15] vllm.cpp — comparações de atendimento com vLLM
[16] vllm.cpp — comparação de CPU com llama.cpp e denominadores superados
[17] vllm.cpp — levantamento exploratório em AMD Strix Halo
[18] vLLM — documentação atual de GGUF e plugin
[19] vLLM — paralelismo e escala
[20] vLLM — arquitetura e processos
[21] vLLM — instalação e plataformas de hardware
[22] llama.cpp — apresentação e backends
[23] llama.cpp — recursos e opções do servidor
[24] llama.cpp — licença MIT
[25] vllm.cpp — conectores de KV e limitações
[26] vllm.cpp — entradas multimodais no servidor HTTP
Primera actualización de Plasma 6.8
Me alegra compartir con todos vosotros la primera actualización de Plasma 6.8, iniciando así una serie de revisión de software que le dotará de más estabilidad, mejores traducción y resolución de errores. Estas actualizaciones son 100% recomendables y casi obligatorias para cualquier usuario ya que lo único que hacen es mejorar la versión sin comprometer sus funcionalidades.
Primera actualización de Plasma 6.8
No existe Software creado por la humanidad que no contenga errores. Es un hecho incontestable y cuya única solución son las actualizaciones. Es por ello que en el ciclo de desarrollo del software creado por la Comunidad KDE se incluye siempre las fechas de las mismas siguiendo una especie de serie de Fibonacci.
Así que me congratula en presentar que ayer martes 20 de octubre de 2026, una semana después de liberar el código de Plasma 6.8 la Comunidad KDE presenta la primera actualización de errores.

Más información: KDE
Las novedades generales de Plasma 6.8
Hoy es un buen día para recordar sus principales novadades:
- Sustitución del fondo de pantalla predeterminado: El fondo de pantalla Waterfall ha sido reemplazado por la nueva imagen Hanabi en la suite de estilos Breeze.
- Soporte para el calendario nepalí: Se ha añadido compatibilidad con el calendario nepalí (Bikram Sambat) dentro de la applet de calendario alternativo (Alternatecalendar).
- Mejoras en las decoraciones de ventanas GTK4: Se corrigieron problemas como el desbordamiento de botones y la eliminación de esquinas redondeadas inapropiadas en ventanas GTK4 que no utilizan CSD (Client-Side Decorations).
- Compatibilidad con decoraciones solo de sombra: La librería de decoración de ventanas y Breeze añaden soporte nativo para decoraciones basadas únicamente en sombras (shadow-only decorations).
- Avances y rediseño en Discover: Se añadió una nueva función de vista previa de AppStream (AppStream Preview Backend), además de incluir el estado de progreso como una sección ordenable en la lista de tareas.
- Ajustes en el menú de Bluedevil (Bluetooth): Se ha reubicado el botón de configuración para sacarlo del menú tipo hamburguesa, mejorando la accesibilidad para el usuario.
- Integración del buscador en la applet de sesiones de Kate: Se ha sustituido el campo de texto estándar por un campo de búsqueda dedicado (SearchField).
- Centrado de la ubicación en el widget del tiempo: Se ha optimizado el diseño en la applet del clima para centrar la etiqueta con la ubicación dentro del panel superior.
- Rediseño del panel de permisos para Flatpak: La página del módulo de control (KCM) para gestionar los permisos de Flatpak se ha migrado al nuevo formato de formularios (Forms).
- Mejoras en la experiencia de fallos (DrKonqi): Se renovó la interfaz gráfica del visor de volcados de memoria (coredump-gui) a módulos QML y se ajustó el seguimiento para registrar y notificar múltiples bloqueos o cierres inespera
Más información: KDE
-
Primera actualización de Plasma 6.8
 Me alegra compartir con todos vosotros la primera actualización de Plasma 6.8, iniciando así una serie de revisión de software que le dotará de más estabilidad, mejores traducción y resolución de errores.
-
Lanzado Plasma 6.8, Edición del 30.º aniversario
 El tiempo pasa inexorable y la Comunidad KDE lo aprovecha para mejorar, versión tras versión, la joya de su corona: el escritorio Plasma. Hoy me complace anunciar que ha sido… Leer más: Lanzado Plasma 6.8, Edición del 30.º aniversario


La entrada Primera actualización de Plasma 6.8 se publicó primero en KDE Blog.
Releasing version 25
Agama 25 is here, and while it does not carry any single headline feature, it bundles a handful of changes requested by users and some groundwork for what is coming next.
This is the first release after openSUSE Leap 16.1, starting the work toward Tumbleweed, Slowroll, and Leap 16.2.
Let's see what's new.
A web-based terminal
Agama's web UI now features an actual terminal. Until now, if you needed a shell on the system you
were installing, your options were limited to switching to a different virtual console (e.g.
Ctrl+Alt+F8) if you had local access, or connecting through SSH.
Now you can just open a terminal from the comfort of Agama's web UI, without leaving the browser.
Leaving before it's too late
As several users requested, Agama now offers an exit option. You will find it from the very beginning of the process, letting you reboot or shut down the machine if you change your mind.
It is important to note that the option is only available before the installation starts: cancelling while Agama is already applying changes to the system could leave it in an unpredictable and potentially unbootable state, so the exit option disappears as soon as the installation is underway.
Enhanced port selection
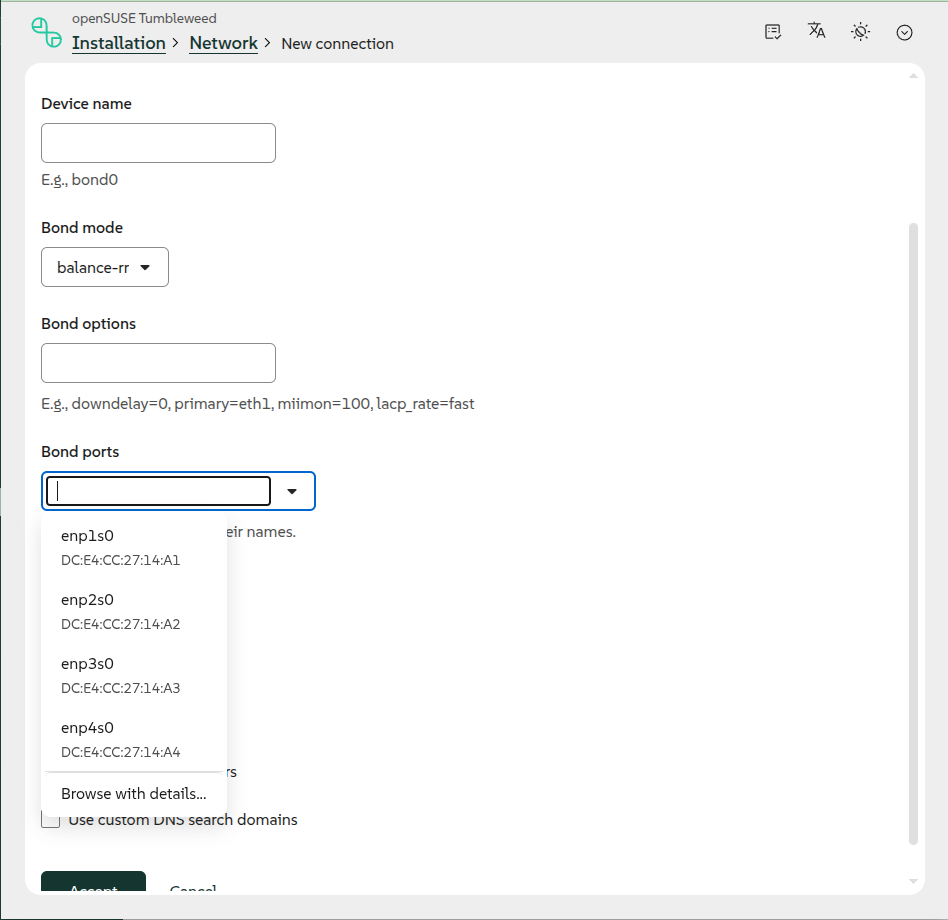
Until now, the ports of a bond or a bridge had to be typed by hand in a free-text field, with only a line listing the existing device names as a hint. A typo was silently accepted, and the field did not scale well past a handful of NICs.
In Agama 25, the ports selection uses a searchable multi-select field instead: the devices found in the system are offered in a list you can filter as you type, and a name can still be written out by hand for a device that is not present in the system yet.
Towards Tumbleweed adoption
Behind the scenes, we keep working with the Tumbleweed maintainers to make Agama the installer for the distribution. There is still no date for that to happen, but we are getting closer. Recent examples of that effort are adjusting the registration support and 32-bit media build and adding riscv64 support, the latter contributed by Andreas Schwab.
Cutting ties with YaST packages
Agama was born on top of several YaST packages, reusing logic that was already there instead of rewriting it from scratch. We are now reducing that reliance, bringing into Agama's own codebase just the parts it actually needs instead of pulling in whole YaST modules. So far this effort covers the AutoYaST-related code, and more areas will follow.
Polishing and publishing our OpenAPI and JSON schemas
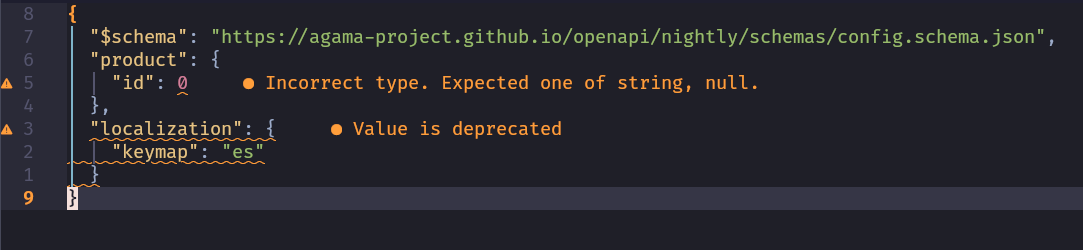
Agama exposes its HTTP API through an OpenAPI specification and validates its configuration and profile files against JSON schemas. We have been polishing both and, more importantly, publishing them with stable URLs at Agama's documentation site.
Having them published this way is useful well beyond Agama itself: it allows other tools to generate
clients, validate requests, or simply let people browse the API without digging through the source
code. The JSON schemas are useful on their own too. For instance, adding a "$schema" key pointing
to the right schema at the top of your AutoYaST-like profile or configuration file is enough for
many editors to offer autocompletion and inline validation as you type.
Keep in touch
On top of all that, we have also been busy with a bunch of smaller fixes and improvements that did
not make it into this post, like reporting more details about network devices or setting
systemd-boot as the default bootloader for MicroOS.
As always, you can take a look at the project at GitHub or
drop by the #yast channel at Libera.chat if you have questions, feedback
or just want to say hello.
Stay tuned!